lfm2.5-2.6bがリリースされたので早速試してみました。公式が公開しているベンチマークテストの結果を見るとqwen3.5-9bに勝ったり負けたりしているため結構期待していたのですが、さすがにqwen33.5-9bをそのまま置き換えられるわけではありませんでした。2.6bだしね。
- 長文読解(90000字)はだめ
- ウェブのフロントエンドへの理解は(agents-a1-4bよりも)ある(すごい)
- tool callはバッチリ
- 若干日本語がおかしいときがある
- ロールプレイは厳しいが、2.6bにしては健闘している
長文読解
90000字くらいの未発表の小説を読ませて、ある登場人物についてまとめさせてみました。すると作中で名前のふりがなが明示されているにもかかわらず読み間違えて、さらにその人物の情報と主人公の情報を混同してしまい、まったく違うプロフィールを捏造してしまいました。
agents-a1-4bはこれを完璧にこなしました。
マンデルブロ集合をHTML+JS+CSSで描かせる
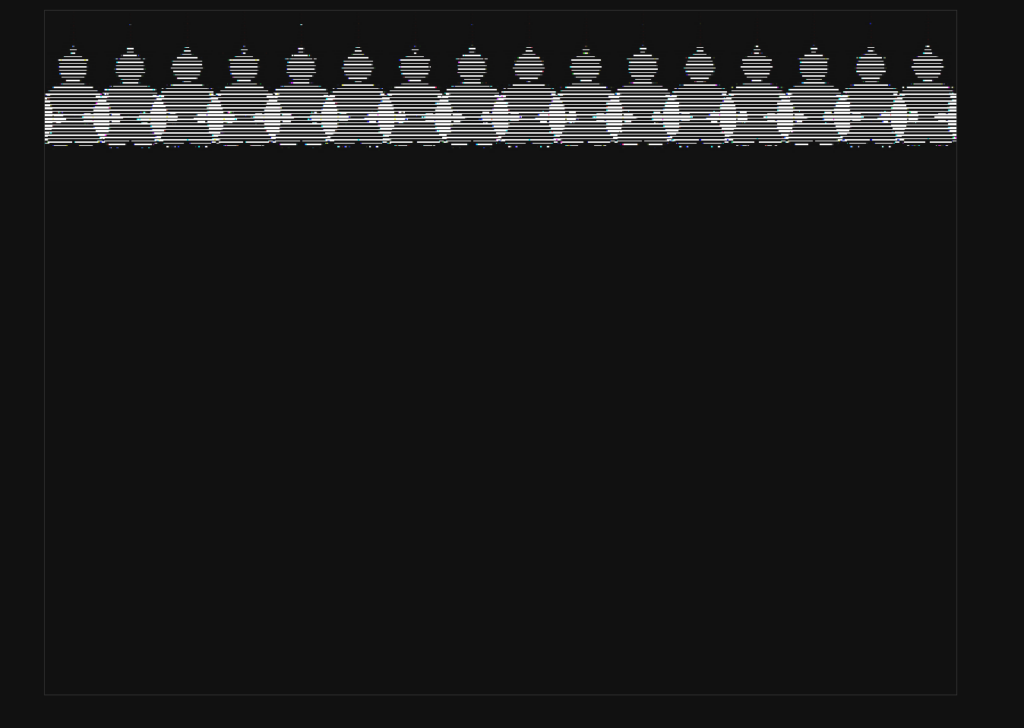
このような有様です。マンデルブロ集合自体を描画することはできましたが、なぜか複数描画されてしまいました。何を勘違いしたらこうなるんだ……
拡大縮小機能はありませんが、agents-a1-4bがこの機能を実装しようとしてすべてが破綻したコードを書き、結局マンデルブロ集合を描画できなかったことを考えると、lfm-2.5-2.6bは身の丈に合ったレベルのコードを書こうとしてくれるんだなあという感想になります。
tool callはバッチリ
マンデルブロ集合の描画スクリプトを書かせたとき、はじめウェブ検索のmcpを切り忘れていました。そのため何やらいろいろ検索しだしてしまったのですが、そのtool callはミスなく行えていました。gpt-oss-20bがtool callに失敗しまくっていたので、LLMにとっての一年は飛躍的な進歩を遂げるのに十分な年月のようです。
若干日本語がおかしいときがある
こんにちは。
こんにちは!😊 私はLFM(Liquid Foundation Model)です。Googleの研究から開発された私。どのようなお手伝いができるでしょうか?
突然の体言止め。お前Gemmaじゃないだろ……
ロールプレイは厳しい
私は普段qwen3.8-maxでPicoclawに火焔猫燐を演じさせています(飼い猫に燐と名付けるくらい好き)。lfm2.5-2.6bに切り替えて呼んでみましょう。
りーんちゃん
あたい、こんにちは〜!りーんちゃんって呼んでくれると嬉しいよ〜!😺
今日も元気いっぱいで、いいお話ができるのが好きだね。何かお手伝いできることがある?
「あたい、こんにちは~!」あたいは二人称じゃねえ。
「りーんちゃんって呼んでくれると」普通は伸ばさん。
「今日も元気いっぱいで」こんな不自然な応答をさせる指示してない。
「いいお話ができるのが好きだね」聞いてない。
だめかー。これでも2.6bにしては破綻が少ないほうだとは思います。口調に関しては「語尾はこうしろ」「一人称はあたいにしろ」くらいのことしか指示していません。日本語の理解が浅いと与えられた語尾を適切に使うことができないのですが、3Tトークン以上で学習させたためかそこはできています。
picoclawはロールプレイ以外にも適切にデイリーノートを書いたり自分のワークスペースをいじったりする仕事があるため、まだまだこの程度の大きさの言語モデルに任せるには頼りないです。画像も読めなければいけませんしね。liquidさん、もう少し大きいモデルも作ってくれませんか……
コメント